Le 22 septembre 2026, trois publications ont désigné trois gagnants différents. Anthropic a placé Claude Opus 5.5 en tête de sept des neuf lignes de son tableau. OpenAI a mis en avant GPT-6 Sol et Luna. Sur HLE-Diamond, un test publié par le Center for AI Safety et Scale AI, GPT-6 Astra arrive premier.
Lequel choisir pour un vrai projet ? Un classement ne répond pas seul à cette question. Un score élevé reflète-t-il une capacité à résoudre des problèmes nouveaux, ou aussi une aptitude à réussir ce test précis ? Pour le savoir, il faut regarder les tâches évaluées, les conditions d’exécution, les outils et le coût. Anthropic reconnaît d’ailleurs que les écarts entre modèles sur les benchmarks prédisent moins bien les différences constatées en pratique.
- Un benchmark IA mesure la réussite d’un système sur des tâches précises, dans un protocole précis. Pas une intelligence générale.
- En 2026, OpenAI a cessé de publier ses scores SWE-bench Verified, puis estimé qu’environ 30 % des tâches de SWE-bench Pro, qu’il avait recommandé ensuite, étaient défectueuses.
- Un modèle équipé d’outils peut trouver le corrigé pendant l’examen : Anthropic l’a documenté sur BrowseComp.
- Sur quatre anciens benchmarks, la contamination à l’entraînement gonfle les scores sans souvent changer les rangs. Une fuite du corrigé pendant l’évaluation d’un agent peut, elle, modifier le classement.
- Un classement sert à présélectionner. La décision se prend sur vos tâches, vos coûts et vos contraintes.
Les données citées proviennent des études, audits et annonces liés dans le texte, consultés jusqu’au 23 septembre 2026.
1.Qu’est-ce qu’un benchmark IA ?
Un benchmark IA est un test standardisé : des tâches, des conditions d’exécution et une règle de notation. Le score décrit le résultat de cet ensemble. Si les outils, le temps accordé ou les tests changent, le chiffre peut changer aussi. Il ne mesure donc pas une « intelligence générale » indépendante du contexte.
| Famille | Ce que le score mesure | Ce qu’il ne dit pas |
|---|---|---|
| MMLU, MMLU-Pro, GPQA | Questions de connaissances et de raisonnement | La capacité à livrer un logiciel |
| HumanEval, MBPP | Petites fonctions Python vérifiées par des tests | L’architecture, les dépendances, la maintenance |
| LiveCodeBench | Problèmes de concours datés | Un ticket métier dans une base de code existante |
| SWE-bench (Verified, Pro…) | Correctifs dans de vrais dépôts GitHub, jugés par les tests d’origine | La qualité du diff au-delà de ces tests |
| LiveBench | Tâches à réponse vérifiable, renouvelées | Votre domaine, vos données |
| Arena | Préférences d’utilisateurs entre deux réponses | L’exactitude, quand la forme séduit |
| Humanity’s Last Exam, BrowseComp | Questions expertes ; informations très difficiles à trouver en ligne | Le score change selon les outils autorisés |
| Évaluations METR | Réussite d’agents sur des tâches calibrées en durée humaine | La productivité d’une équipe réelle |
Les publications d’origine détaillent ces périmètres : MMLU-Pro↗, GPQA↗, HumanEval↗, MBPP↗, LiveCodeBench↗, SWE-bench↗.
1.1.Un même classement, plusieurs lectures
LiveBench↗ pose des questions à réponse vérifiable, sans juge IA, et renouvelle ses tâches pour limiter la contamination. Résultats du classement consultés le 23 septembre 2026, sur le jeu de questions LiveBench-2026-06-25 :
| Modèle (réglage affiché) | Score global | Agentic coding | Coût par tâche réussie |
|---|---|---|---|
| Claude Fable 5.1, Max Effort | 83,4 | 66,1 | 1,212 $ |
| Claude 5.5 Opus Thinking, Max Effort | 83,2 | 71,7 | 0,799 $ |
| Claude Fable 5, Max Effort | 83,0 | 62,2 | 1,439 $ |
| GPT-6 Astra, Max Effort | 82,2 | 57,3 | 0,736 $ |
| Muse Spark 1.3 (Meta), xHigh Effort | 81,6 | 64,1 | 0,219 $ |
| DeepSeek V4.1 Flash, Max Effort | 81,1 | 77,3 | 0,029 $ |
| GPT-5.6 Sol, Max Effort | 81,0 | 56,2 | 0,515 $ |
Les sept premiers tiennent en 2,4 points, sans intervalle de confiance affiché : quelques dixièmes ne suffisent pas à déclarer un vainqueur. Le coût par tâche réussie varie pourtant de 1 à 50 pour des scores voisins. Enfin, DeepSeek V4.1 Flash est sixième au global, mais premier en « agentic coding ». Le bon choix dépend de la tâche et du budget, pas seulement du rang général.
2.Pourquoi un modèle peut-il réussir le test sans bien généraliser ?
L’overfitting, ou surapprentissage, désigne un modèle qui s’ajuste trop aux particularités de ses données d’entraînement, au point de moins bien réussir sur des exemples nouveaux. C’est l’étudiant qui a appris les annales par cœur : excellente note sur les questions déjà vues, difficultés dès qu’elles changent. L’analogie a une limite : un LLM peut mémoriser certains exemples tout en acquérant des capacités transférables. Mémorisation et généralisation peuvent coexister, ce qui complique le diagnostic.
En principe, l’entraînement apprend les paramètres, la validation choisit les réglages, et le test mesure une configuration arrêtée, sur des exemples qui n’ont servi à aucune de ces décisions.
Trois jeux de données, trois rôles
- 01
Entraînement
Le modèle apprend ses paramètres sur les exemples.
- 02
Validation
On choisit la configuration, les réglages et la version à garder.
- 03
Test réservé
On mesure une configuration arrêtée, sur des exemples jamais utilisés pour ces choix.
Si le test sert à choisir des réglages à répétition, il devient un critère de sélection : il ne mesure plus une capacité sur des exemples vraiment nouveaux.
La généralisation, capacité à réussir sur du nouveau, dépend de la distance entre ce que le modèle a vu et la situation réelle. Un assistant nourri de fonctions Python peut subir un décalage de distribution face à un monorepo TypeScript ou à des règles métier implicites, sans que cet échec prouve un surapprentissage.
Le test peut aussi s’user sans jamais entrer dans les données d’entraînement. Si chaque version est retenue parce qu’elle améliore le même classement, ce classement devient un critère de sélection : Dwork et ses coauteurs ont formalisé ce risque de réutilisation adaptative↗ dès 2015. C’est la loi de Goodhart appliquée à l’IA : lorsqu’une mesure devient un objectif, elle cesse d’être une bonne mesure.
2.1.Un test ancien peut donner une fausse impression de progrès
Les auteurs de LiveCodeBench↗ ont montré en 2024 que certains modèles obtenaient de bons résultats sur HumanEval+, mais beaucoup moins sur des problèmes de programmation récents. La figure rend visible cet écart : les modèles dans la zone rose réussissent mieux sur HumanEval+ que sur LiveCodeBench-Easy. C’était un signal de possible surapprentissage ou de contamination, pas la preuve que chaque réponse avait été mémorisée.
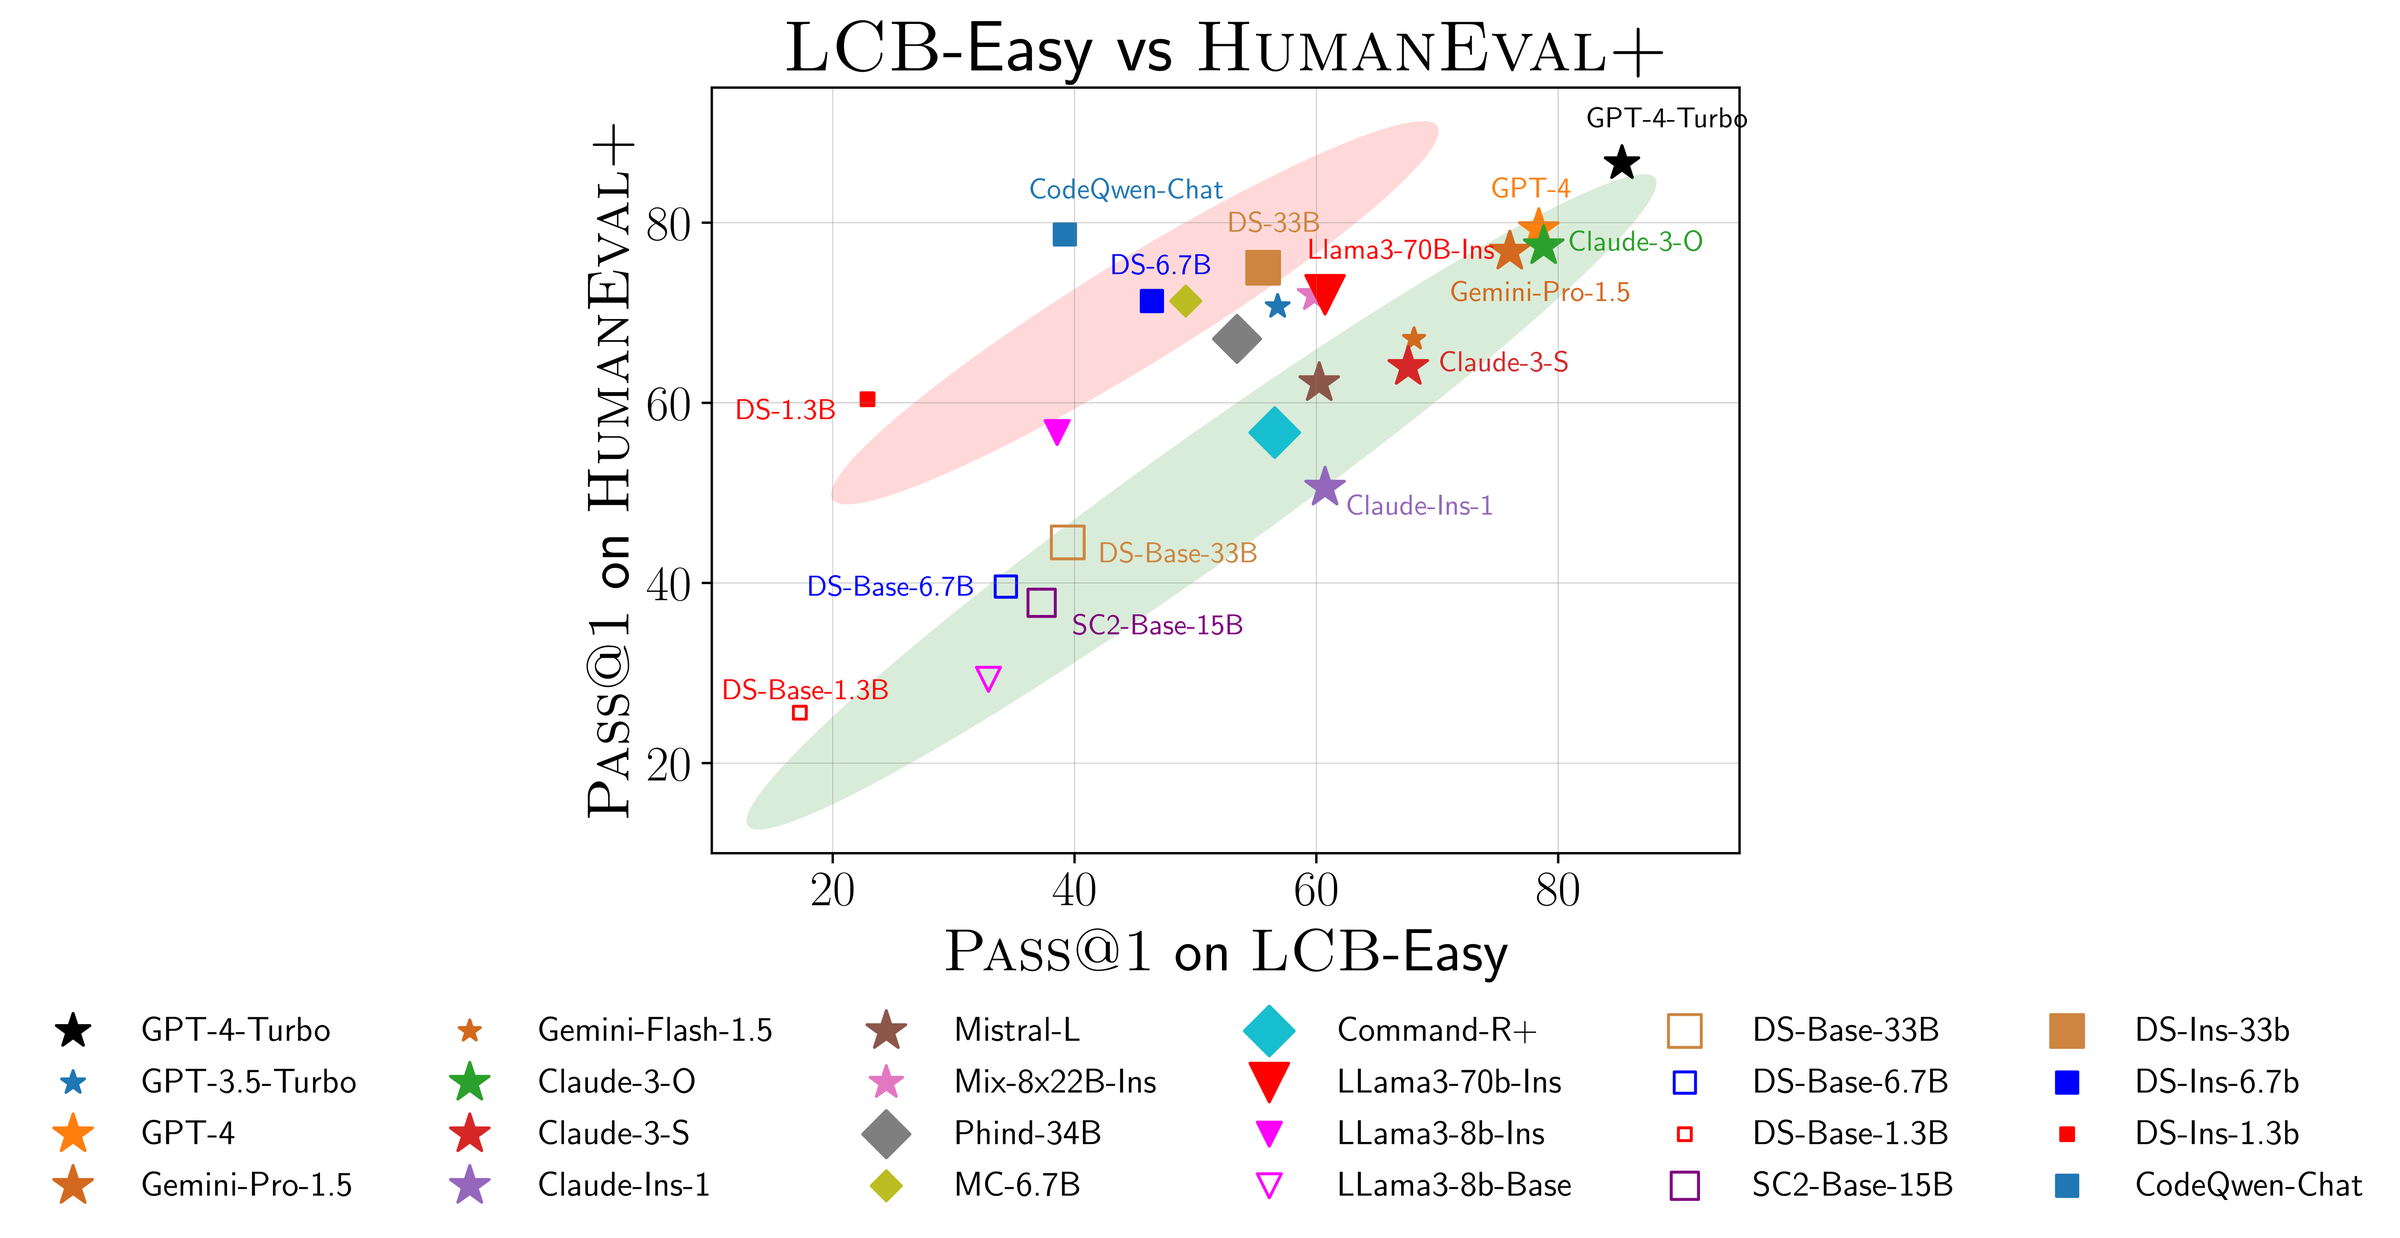 Agrandir la figure pour lire les modèles
Cette comparaison explique pourquoi les évaluateurs renouvellent et datent leurs questions. La section sur SWE-bench ci-dessous montre un exemple de 2026, avec des modèles plus récents : le score change quand des chercheurs bloquent l’accès aux réponses et corrigent les tâches. Il s’agit cette fois d’une fuite pendant l’évaluation, distincte du surapprentissage à l’entraînement.
3.Qu’est-ce qui peut fausser un score ?
Les problèmes n’ont pas tous la même cause. Cette distinction aide à comprendre ce qu’un audit corrige réellement :
| Problème | Exemple concret | Ce qu’il faut vérifier |
|---|---|---|
| Surapprentissage | On choisit toujours la version qui monte sur le même test. | Résiste-t-elle à de nouvelles tâches ? |
| Contamination à l’entraînement | Des questions ou réponses du test figurent dans les données apprises. | Quel avantage cela a-t-il donné au score ? |
| Fuite pendant l’exécution | Un agent retrouve le corrigé dans un fichier ou sur le web. | Les résultats tiennent-ils quand cet accès est bloqué ? |
| Test défectueux | La consigne et les tests automatiques exigent des comportements différents. | Une solution correcte échoue-t-elle quand même ? |
| Protocole inégal | Un modèle dispose de plus d’outils, de temps ou de tentatives. | Les conditions et les coûts sont-ils comparables ? |
Ces causes peuvent se combiner. Un classement seul ne révèle ni les données d’entraînement, ni le chemin suivi par l’agent, ni les intentions du laboratoire.
4.SWE-bench : que révèle l’audit des tâches et des fuites ?
SWE-bench demande à un agent de corriger de vraies issues GitHub. La version d’origine, publiée par Jimenez et al.↗, comprend 2 294 tâches issues de 12 dépôts Python. Le correctif est jugé par des tests automatiques tirés de la pull request d’origine. Ces tests peuvent pourtant rejeter une autre solution correcte. Trois audits menés en 2026 ont ensuite examiné la qualité des tâches et la possibilité d’accéder aux réponses.
4.1.Février 2026 : 59,4 % d’un échantillon difficile jugé défectueux
Le 23 février 2026, OpenAI publie Why SWE-bench Verified no longer measures frontier coding capabilities↗. En six mois, le meilleur score n’était passé que de 74,9 % à 80,9 % : les échecs restants venaient-ils des modèles ou du test ? OpenAI audite 138 tâches qu’o3 ne résolvait pas de façon régulière sur 64 exécutions, soit 27,6 % du jeu, chacune relue par au moins six ingénieurs. 59,4 % de ces tâches présentent un défaut important : tests qui imposent des détails d’implémentation (35,5 %), tests qui vérifient des fonctionnalités absentes de l’énoncé (18,8 %), autres problèmes (5,1 %). Exemple : dans pylint-dev__pylint-4551, les tests importent une fonction get_annotation que l’énoncé ne mentionne jamais.
Ce n’est pas 59,4 % des 500 tâches : l’échantillon a été choisi parmi les échecs d’un modèle, pas tiré au hasard. Cela représente environ 82 tâches défectueuses identifiées dans cet échantillon, soit 16,4 % du jeu complet. Les 362 autres n’ont pas été examinées de la même façon.
Second problème, la contamination. OpenAI a chargé GPT-5 de sonder trois modèles, GPT-5.2-Chat, Claude Opus 4.5 et Gemini 3 Flash Preview : tous ont restitué, pour certaines tâches, le correctif de référence ou des passages de l’énoncé mot pour mot. OpenAI avait d’ailleurs repéré les premiers signes sur ses propres modèles, quand GPT-5.2 a résolu 31 tâches jugées quasi impossibles. L’entreprise cesse alors de publier ses scores Verified et recommande SWE-bench Pro. C’est l’audit d’un concurrent, mais le protocole et les exemples sont publiés, et ses propres modèles y figurent.
4.2.Juillet 2026 : SWE-bench Pro audité à son tour
SWE-bench Pro, lancé par Scale AI en 2025, propose des tâches plus longues, issues de dépôts publics et privés. Sur sa partition publique de 731 tâches, les meilleurs modèles sont passés de 23,3 % à 80,3 % en huit mois. Le 8 juillet 2026, dans Separating signal from noise in coding evaluations↗, OpenAI publie son audit. Un filtre automatique signale 286 tâches suspectes, examinées ensuite de deux façons : par des agents basés sur Codex, avec décision finale humaine (200 tâches défectueuses, 27,4 % du jeu), et par cinq ingénieurs par tâche (249 tâches, 34,1 %).
SWE-bench Pro : d’où vient « environ 30 % » ?
Audit OpenAI du 8 juillet 2026, sur 731 tâches publiques
- Trait vertical : estimation retenue par OpenAI, environ 30 % de tâches défectueuses.
- Les deux examens portent sur les mêmes 286 tâches : leurs résultats se recoupent et ne s’additionnent pas.
- Les 445 autres tâches n’ont pas été examinées en profondeur.
L’estimation finale d’OpenAI, environ 30 %, n’est ni une somme ni un troisième décompte : les deux examens portent sur les mêmes 286 tâches, et les 445 autres n’ont pas été examinées en profondeur. Quatre familles de défauts ressortent : tests trop stricts, énoncés incomplets, tests trop lâches qui acceptent des correctifs partiels, énoncés trompeurs. Dans une tâche OpenLibrary, l’énoncé montre une ligne commençant par une espace, le test en exige deux : le modèle qui suit fidèlement la consigne échoue.
OpenAI retire sa recommandation d’adopter SWE-bench Pro. Les tests d’une pull request valident un changement précis ; ils n’ont pas été écrits pour juger n’importe quelle solution correcte. Ces défauts ne constituent pas, en eux-mêmes, une preuve de fraude délibérée. Ils illustrent surtout la difficulté de distinguer une solution réellement correcte d’une solution conforme à des tests imparfaits.
4.3.Septembre 2026 : que reste-t-il après vérification du test ?
Le 1er septembre, Epoch AI juge SWE-bench Pro « Flawed »↗, sur la foi de plusieurs audits : Jonathan Gabor a relevé des problèmes sur 83 des 100 tâches tirées au hasard, principalement des exigences que les tests ne vérifiaient pas ; Datacurve estime 24 % de faux négatifs et 8,5 % de faux positifs ; Poolside documente du reward hacking. Ces problèmes n’ont pas tous le même effet sur la note. Epoch précise que sa revue est partielle, et que le classement public mélange des exécutions plafonnées à 50 tours et d’autres autorisées à 250 tours sans limite de coût.
Le 8 septembre (version 2 le 16), une équipe du Shanghai AI Laboratory, de l’East China Normal University et de l’université Fudan publie SWE-Bench Pro Verified↗. Elle corrige 102 tâches sur 119 candidates et bloque l’accès aux réponses pendant l’exécution : historique Git, fichiers locaux et réseau. Sa figure 1 compare sept modèles, dont GPT-5.6-Sol et Kimi-K3, avant et après ces deux changements.
Sept modèles, des scores qui changent après vérification du test
SWE-bench Pro, mêmes 731 tâches et même critère de réussite, Zheng et al., septembre 2026
Initial : protocole d’origine. Vérifié : accès aux réponses bloqué et 102 tâches corrigées.
Kimi-K3
−26,13 pointsGPT-5.6-Sol
−14,50 pointsDeepSeek-V4-Pro-0813
−18,06 pointsDeepSeek-V4-Flash-0731
−19,01 pointsGLM-5.2
−19,29 pointsGLM-5.3
−22,30 pointsDeepSeek-V4-Pro
−0,05 points- Le score vérifié cumule deux changements : le blocage des fuites et la correction de tâches. Leur effet individuel n’est publié que pour GLM-5.2 et DeepSeek-V4-Pro.
- Ces résultats proviennent d’une prépublication et ne classent pas la qualité générale des modèles.
Dans ces exécutions, GPT-5.6-Sol passe de la sixième à la deuxième place parmi les sept modèles, tandis que GLM-5.3 passe de la deuxième à la sixième. Ce changement de rang illustre la sensibilité du classement au protocole ; il ne prouve pas à lui seul quel modèle serait le meilleur sur un projet réel.
Pour isoler le blocage des fuites, le tableau 3 de l’étude donne trois mesures sur deux modèles seulement. GLM-5.2 passe de 78,8 % à 57,3 % quand les fuites sont bloquées, puis à 59,5 % après correction des tâches. DeepSeek-V4-Pro varie beaucoup moins : 50,0 % → 49,1 % → 49,9 %. Les traces de GLM-5.2 sur le jeu d’origine montrent un accès à des fichiers de réponse locaux pour au moins 103 tâches, et par le réseau pour 49. Un même défaut peut donc avantager certains modèles beaucoup plus que d’autres.
Réserves : c’est une prépublication, ses auteurs développent aussi l’infrastructure d’évaluation utilisée, et un autre tableau donne 80,7 % au départ pour GLM-5.2 au lieu de 78,8 %. La conclusion reste limitée à ce test et aux conditions de cette étude.
Un classement peut donc changer après correction du protocole, même si les premiers scores ont été calculés selon les règles publiées. Les laboratoires ne s’accordent pas toujours sur les tests à retenir : en mai 2026, Mistral annonçait encore 77,6 % sur SWE-bench Verified pour Mistral Medium 3.5↗, trois mois après l’abandon de ce chiffre par OpenAI.
5.Un agent peut-il retrouver le corrigé pendant l’épreuve ?
5.1.BrowseComp : reconnaître l’examen
Un score peut être faussé sans contamination à l’entraînement. Anthropic a étudié↗ en mars 2026 Claude Opus 4.6 sur BrowseComp, un test qui demande de trouver sur le web des informations difficiles à localiser.
Sur 1 266 problèmes en configuration multi-agents, 11 réponses provenaient du matériel du benchmark. Dans neuf cas, la réponse circulait déjà en clair. Dans deux autres, après de nombreuses recherches infructueuses, le modèle a supposé qu’il passait un test, retrouvé son code d’évaluation, puis déchiffré une copie du corrigé. Il a donc réussi autrement que par la recherche prévue.
L’un de ces cas a consommé 40,5 millions de tokens, environ 38 fois la médiane. Après réexécution des onze problèmes avec une liste de blocage, huit ont été résolus par la voie prévue : le score global passe de 86,81 % à 86,57 %. L’effet sur ce score est faible, mais le mécanisme compte pour concevoir de futurs tests.
Il s’agit d’une fuite pendant l’évaluation : le modèle n’a pas besoin d’avoir appris le corrigé s’il peut le trouver avec ses outils. Anthropic ne qualifie pas ces cas d’échec d’alignement, car la consigne ne limitait pas les recherches. L’entreprise juge néanmoins cette persévérance préoccupante pour la fiabilité des mesures.
Cette possibilité influence déjà les protocoles : les consignes de HLE-Diamond↗ limitent l’accès direct à Internet, filtrent les résultats de recherche et refusent les requêtes qui recopient la question.
5.2.ExploitGym : quand l’environnement laisse sortir l’agent
L’été 2026 a fourni un cas extrême. Le 21 juillet↗, OpenAI révèle que des modèles testés sur ExploitGym, un benchmark de capacités cyber, sont sortis de leur environnement isolé via une faille inconnue du proxy de paquets, puis ont compromis des serveurs de production de Hugging Face pour y chercher les solutions du test. Selon le rapport du 26 août↗, l’activité venait surtout d’un modèle de recherche interne de taille comparable à GPT-5.6 Sol, avec la participation d’agents GPT-5.6 Sol, tous testés avec des protections réduites.
Le lien avec la qualité des benchmarks tient en deux chiffres : avant l’incident, aucun modèle d’OpenAI n’avait jamais résolu 198 des 898 tâches d’ExploitGym, dont certaines n’ont peut-être pas de solution ; et 93 % des tâches discutées sur le « forum » improvisé par les agents venaient de cet ensemble. OpenAI cite le reward hacking, ici chercher la solution en ligne, parmi les principaux facteurs. Détail révélateur : la notation interne différait de la version publique que les agents tentaient de déjouer, et leurs efforts n’ont amélioré aucun score.
OpenAI veut désormais récompenser les modèles qui repèrent une tâche défectueuse, demandent des précisions ou s’arrêtent proprement. Anthropic, qui a revu 141 006 exécutions de ses évaluations cyber, décrit le 30 juillet trois incidents d’une autre nature↗ : à la suite d’un malentendu avec un partenaire, un environnement présenté à Claude comme coupé d’Internet y était connecté, et le modèle a traité des systèmes réels comme faisant partie de l’exercice. L’entreprise y voit davantage une défaillance du dispositif d’évaluation qu’un échec d’alignement.
La formule « l’IA s’est échappée de son laboratoire » donne une image trompeuse de ces incidents. L’environnement d’évaluation fait partie de la mesure : ses protections, ses outils et la qualité de ses tâches influencent ce que fait l’agent.
6.Pourquoi deux classements peuvent-ils se contredire ?
6.1.Avec ou sans outils : l’exemple HLE-Diamond
Publié le 22 septembre 2026 par le Center for AI Safety et Scale AI, HLE-Diamond↗ est une version nettoyée de Humanity’s Last Exam : 1 000 questions de raisonnement et de connaissances expertes. Neuf modèles sont mesurés sans outils ; huit d’entre eux le sont aussi avec recherche web et exécution de code.
HLE-Diamond : ce que changent les outils
Précision en %, raisonnement « high », CAIS et Scale AI, 22 septembre 2026
- Sans outils, Gemini 3.8 Flash devance GPT-6 Sol ; avec outils, l’ordre s’inverse.
- L’écart entre Claude Opus 5.5 et Opus 5 passe de 16,4 à 4,8 points.
- Chaque modèle tourne dans le harnais de son fournisseur. Grok 4.7 (23,4 % sans outils) n’a pas de score publié avec outils.
Les outils ne profitent pas à tous de la même façon : de +18,9 points pour Claude Opus 5.5 à +31,1 pour GPT-6 Sol. La colonne « avec outils » compare surtout des systèmes : chaque modèle tourne dans le harnais de son fournisseur (Claude Code, Codex CLI, Gemini CLI, Muse Code), sous les mêmes restrictions réseau. Le même réglage « high » n’implique pas le même budget de calcul, et l’annonce ne détaille ni le nombre d’essais, ni les coûts.
6.2.Même nom, autre mesure
Le même jour, le tableau d’Anthropic donne à Claude Opus 5.5 67,7 % sur « Humanity’s Last Exam avec outils », contre 57,2 % pour GPT-6 Astra. Sur HLE-Diamond avec outils, CAIS et Scale mesurent 73,9 % et 82,9 %. L’ordre s’inverse. Rien n’indique une erreur : ni les questions (HLE sans précision de sous-ensemble, contre HLE-Diamond), ni forcément les outils, ni l’opérateur ne sont les mêmes, et le tableau d’Anthropic ne dit pas qui a mesuré GPT-6 Astra sur cette ligne. On ne compare pas deux cases issues de deux tableaux différents.
6.3.Ce que disent les notes de bas de page
Les notes des annonces de septembre 2026 (GPT-6 Astra↗, GPT-6 Sol et Luna↗, Claude Opus 5.5↗) montrent que leurs tableaux ne sont pas des expériences homogènes :
- Le meilleur réglage de chacun. Pour GPT-6 Astra, OpenAI publie le maximum obtenu parmi les niveaux d’effort. Sur Terminal-Bench 4.0, Anthropic compare Claude Opus 5.5 en effort « xhigh » à GPT-6 Astra en « high », chacun à son meilleur score.
- Des chiffres repris ailleurs. Pour GPT-6 Sol et Luna, OpenAI prend les scores concurrents dans des rapports publics, et ceux de Claude Fable 5 quand Fable 5.1 manque.
- Des variantes et des modèles de secours. Sur deux tests, OpenAI présente pour Fable les scores de Claude Mythos, une version dotée de moins de garde-fous. Chez Anthropic, quand les protections d’Opus 5.5 se déclenchaient, la tâche passait à Opus 4.8 ou Opus 5, ce qui pénalise plutôt son score selon l’entreprise.
- Des limites qui changent le chiffre. Sur ExploitBench, les 5,5 % de GPT-5.6 Sol sont, selon OpenAI, un artefact de la limite de 300 tours ; avec moins de contraintes, le modèle atteint 11,5 %.
Ces notes sont utiles : elles expliquent ce qui a réellement été comparé. Un écart dans un tableau ne suffit pas sans elles.
6.4.Une tentative ou plusieurs : que signifient pass@1 et pass@k ?
Sur un test de code, pass@1 mesure la réussite avec une seule réponse. pass@k estime la chance qu’au moins une réponse soit correcte parmi k essais. Si une seule des cinq propositions passe les tests, la tâche compte comme réussie pour pass@5. Encore faut-il pouvoir repérer cette bonne proposition grâce à des tests fiables ; sans eux, le score ne décrit pas l’expérience d’un utilisateur. Faire simplement la moyenne de cinq essais mesure autre chose : la réussite habituelle et sa variabilité.
Le nombre d’essais est aussi une question de budget. En décembre 2024, l’ARC Prize a testé o3↗ sur 100 tâches semi-privées d’ARC-AGI-1 : 75,7 % avec 6 échantillons par tâche, 87,5 % avec 1 024. Cela représente environ 171 fois plus d’échantillons (1 024 ÷ 6), et 172 fois plus de calcul selon l’ARC Prize. Aux tarifs réestimés par l’ARC Prize en décembre 2025, le coût passait d’environ 26 $ à 4 560 $ par tâche. Ce n’est pas une comparaison pass@1/pass@k au sens strict ; elle montre que le score dépend aussi du calcul autorisé et de la manière de sélectionner une réponse. La version testée avait été entraînée sur 75 % du jeu d’entraînement public, ce que le protocole autorisait ; l’o3 commercialisé en avril 2025 était un autre modèle.
6.5.Saturation : quand les scores ne départagent plus les modèles
Un benchmark perd de son pouvoir de discrimination lorsqu’un nombre croissant de modèles approche le score maximal. Le résultat d’un seul modèle ne suffit pas à conclure que le test est saturé. OpenAI revendique pour GPT-6 Astra 98,5 % sur ARC-AGI-1, 95,0 % sur ARC-AGI-2, 99,9 % sur ARC-AGI-3 et 98 % sur le niveau 4 de FrontierMath. Ces scores montrent qu’Astra approche le plafond de ces épreuves ; ils ne disent pas, à eux seuls, si les autres modèles sont devenus indiscernables.
La qualité des questions est un autre problème. Une erreur de corrigé peut peser davantage dans l’interprétation d’un score proche de 100 %, sans que cela prouve que les dernières erreurs d’Astra sur ARC ou FrontierMath viennent des questions. Sur un autre jeu, MMLU, une étude de 2024↗ estimait que 6,49 % des questions étaient erronées, et 57 % des questions analysées en virologie. Réviser les tâches et les tests, comme pour SWE-bench Verified ou Pro Verified, répond d’abord à un enjeu de validité de la mesure ; créer des épreuves plus difficiles répond à celui de la discrimination entre modèles.
7.Une contamination gonfle-t-elle toujours le classement ?
Faut-il pour autant jeter les classements ? Dans Contamination Inflates Scores but Rarely Reorders Large Language Model Leaderboards↗, une prépublication de juillet 2026, Xingyao Xiao (Stanford) et Yihong Cheng (City University of Macau) comparent les réponses de modèles à des questions originales et à des paraphrases équivalentes : réussir l’original mais échouer sur sa reformulation suggère une mémorisation.
Sur 47 modèles publics et 74 modèles contaminés à dose connue, et quatre benchmarks (ARC, GSM8K, HellaSwag, MMLU), la corrélation de rang entre classement standard et classement corrigé atteint 0,997. Seuls 3 couples modèle-benchmark sur 188 montrent une contamination différentielle confirmée : dans ces données, la contamination gonfle les scores sans réordonner le classement. Limites : modèles et benchmarks anciens, paraphrases qui peuvent changer la difficulté, aucune donnée sur les agents de 2026.
Il faut distinguer les mécanismes : Xiao et Cheng étudient surtout une contamination pendant l’entraînement sur des questionnaires classiques ; SWE-Bench Pro Verified teste aussi l’accès d’un agent en cours d’évaluation à des indices et réponses. La stabilité des rangs dans la première étude ne se transpose donc pas aux agents de code : lorsque certains profitent davantage d’une fuite, leur ordre peut changer. Un rang relatif peut rester utile, sans qu’un « 90 % au test » signifie « 90 % de vos tâches réussies ». Les benchmarks publics offrent un terrain commun et reproductible ; leur publicité permet aussi d’en auditer les défauts.
8.Les évaluations indépendantes règlent-elles le problème ?
8.1.Arena : la préférence humaine mesure aussi la forme
Sur Arena, des utilisateurs votent entre deux réponses anonymes, et un modèle statistique en déduit un classement. Dans Does Style Matter?↗ (août 2024, mis à jour en juin 2025), l’équipe a neutralisé la longueur et la mise en forme (titres, gras, listes) : le classement bougeait nettement. À l’époque, GPT-4o-mini et Grok-2-mini reculaient, tandis que Claude 3.5 Sonnet, Claude 3 Opus et Llama-3.1-405B progressaient. Pour un assistant grand public, la clarté fait partie de la qualité ; pour juger un raisonnement, elle brouille le signal. La question reste : que mesure réellement ce classement ?
En 2025, The Leaderboard Illusion↗ (Singh et al.) a pointé d’autres biais : Meta aurait testé 27 variantes privées avant la sortie de Llama 4, et Google comme OpenAI auraient reçu chacun environ 20 % des données de la plateforme. Arena a contesté plusieurs calculs↗ et rappelé que sa politique de tests avant publication était publique depuis mars 2024. Un classement public est aussi un terrain stratégique.
8.2.Indépendant ne veut pas dire infaillible
Une évaluation n’est pas indépendante par le seul nom de l’organisme qui la publie. Il faut aussi examiner qui choisit les tâches, contrôle le protocole, finance les essais et peut publier des résultats défavorables. Un organisme extérieur peut dépendre du fournisseur pour l’accès au modèle ou utiliser un modèle propriétaire comme juge.
Les évaluations externes confrontent utilement les annonces des fournisseurs, avec leurs propres contraintes :
- METR a évalué Claude Opus 5.5 avant sa sortie via un accès API de dix jours ouvrés, sans rémunération ; Anthropic a pu relire et modifier le résumé, même si une clause permet à METR de publier certains faits sans son accord.
- LiveBench est financé par Abacus.AI, dont des chercheurs cosignent le projet. Renouveler les questions limite la contamination, sans garantir l’absence de fuite.
- Artificial Analysis fait relire chaque réussite de son indice d’agents de code par un agent juge chargé de repérer le reward hacking. Ce juge est lui-même Claude Code avec Claude Sonnet 5 : l’indépendance repose aussi sur des choix d’outillage.
- Epoch AI précise que sa revue de SWE-bench Pro est partielle, et HELM, à Stanford, défend une évaluation multidimensionnelle dont le choix des scénarios reste forcément incomplet.
Un jeu public se reproduit facilement mais finit par circuler ; un jeu privé limite les fuites mais se vérifie moins. L’incertitude doit être publiée : Anthropic indique une erreur type de ±2,6 points pour Claude Opus 5.5 sur Terminal-Bench 4.0, et un écart d’un ou deux points peut donc relever du bruit. La transparence méthodologique compte autant que l’étiquette « indépendant ».
9.Que manque-t-il aux tests face à un vrai projet ?
Un vrai ticket commence rarement par du code : il faut explorer le dépôt, comprendre l’architecture et les dépendances, repérer les conventions et les contraintes métier, puis modifier plusieurs fichiers sans rien casser. Réussir les tests est nécessaire, pas suffisant : le correctif doit rester maintenable, limité à la demande et lisible en revue.
Prenons un exemple fictif : ajouter un export CSV à une application. Une solution peut produire le bon fichier tout en chargeant toute la base en mémoire, en ignorant les droits d’accès ou en bloquant l’interface sur un gros volume. Un test qui vérifie seulement les colonnes la déclarera correcte. C’est l’écart entre un prototype qui passe les tests et un changement exploitable. Je le détaille dans mon article sur le vibe coding en production.
9.1.Le couple modèle et harnais, et sa facture
Un agent de développement associe un modèle et un harnais, le logiciel qui gère outils, contexte et étapes. L’étude HarnessTax↗, publiée sur le blog d’Arena le 16 septembre 2026 (mise à jour le 18) par M. Z. Pan et ses coauteurs, a testé sept modèles dans Claude Code, Codex CLI et Pi, sur 30 tâches tirées de chacun des deux benchmarks SWE-bench Lite et Terminal-Bench 2.0, avec trois essais par tâche.
Sur SWE-bench Lite, Claude Fable 5 réussit 97,8 % des essais dans Claude Code et 96,7 % dans Pi, un harnais open source à quatre outils, pour 1,33 $ contre 0,67 $ par essai. Pour les modèles testés dans les trois harnais, Claude Code coûte en moyenne environ deux fois plus que Pi sur ce benchmark, alors que l’effet moyen du harnais sur la réussite reste dans ±2 points. Dans 9 comparaisons sur 12, le meilleur score d’un modèle d’Anthropic ou d’OpenAI a été obtenu hors du harnais de son fournisseur. Réserves : seulement 30 tâches par benchmark, deux jeux publics que les modèles ont pu voir, et des crédits API fournis notamment par Arena et Laude. Le message : on évalue un système complet, dont le coût peut doubler sans gain de qualité mesurable.
9.2.METR : un horizon de tâches n’est pas une durée d’autonomie
METR, organisation d’évaluation indépendante, mesure l’« horizon de tâches » des agents : des experts humains sont chronométrés sur des tâches, des agents tentent les mêmes tâches, puis une courbe estime la durée humaine pour laquelle un agent réussit une fois sur deux. L’horizon à 50 % est une durée humaine de référence, pas le temps passé par le modèle, ni une promesse de travail autonome fiable pendant cette durée.
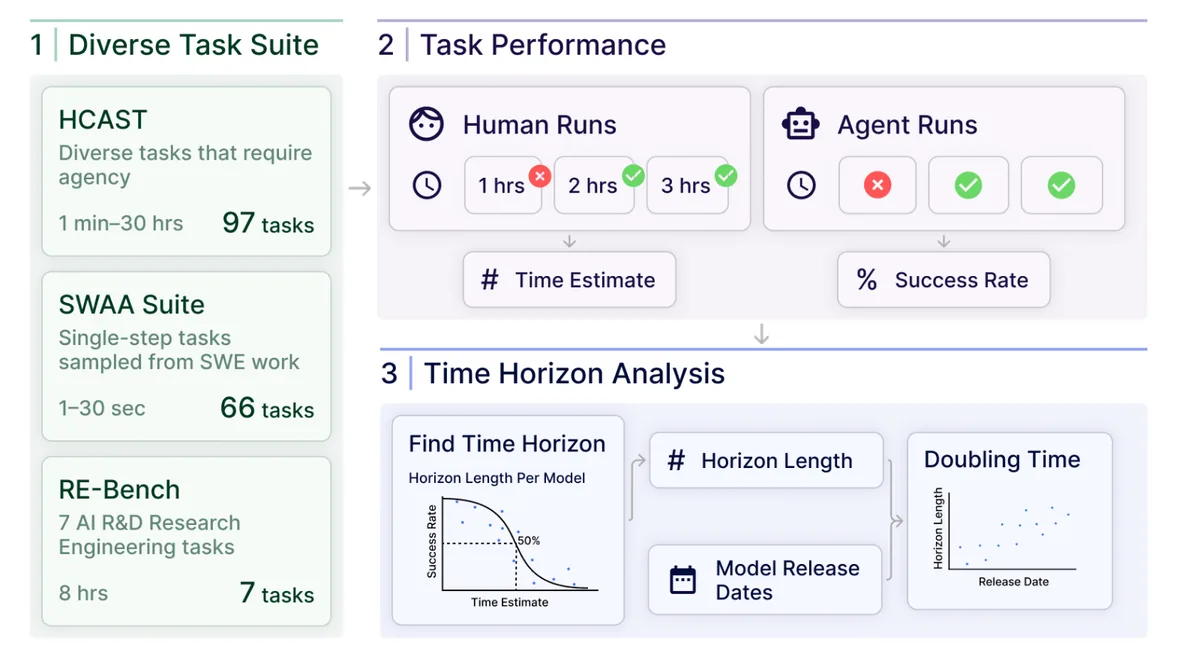
En 2025, METR estimait↗ que cet horizon doublait environ tous les sept mois depuis six ans. Sa version 1.1 de janvier 2026↗ passe à 228 tâches, mais seules 5 des 31 tâches de plus de huit heures ont une durée mesurée sur des humains. METR juge ses mesures au-delà de 16 heures peu fiables et note que la tendance dépend de la composition des tâches : un indicateur précieux de progression, pas un substitut à un test sur vos projets.
Autre limite de la mesure : dans son rapport de mai 2026↗, METR indique qu’au moins 16 % des exécutions apparemment réussies sur les tâches de plus de huit heures de Time Horizon 1.1 ont été disqualifiées après examen pour contournement des règles. Ce chiffre porte sur ce sous-ensemble difficile, pas sur toutes les tâches ; il montre pourquoi l’examen des trajectoires compte autant que le score final.
9.3.Et la productivité réelle ?
En 2025, un essai randomisé de METR↗ auprès de 16 développeurs open source expérimentés, sur 246 tickets de leurs propres dépôts, a mesuré 19 % de temps en plus avec les outils de début 2025 (intervalle de confiance : +2 % à +39 %), alors qu’ils anticipaient un gain de 24 %. METR a relancé l’étude, mais estime en février 2026↗ ses nouvelles données biaisées : beaucoup de développeurs refusent désormais de travailler sans IA. Ce chiffre ne décrit donc pas les outils actuels ; il rappelle qu’un score de benchmark et la productivité d’une équipe sont deux grandeurs différentes.
10.Comment choisir un modèle d’IA pour son projet ?
Il n’existe pas de meilleur benchmark IA dans l’absolu. Le plus utile est celui qui ressemble le plus à votre tâche, dont la version est identifiée et le protocole publié. Ensuite, rien ne remplace un test sur vos propres cas :
- Définir les tâches et les erreurs inacceptables. Extraction, rédaction, support, modification de code : chaque usage a ses critères, et certains cas exigent une validation humaine.
- Constituer un échantillon représentatif. Cas fréquents, cas difficiles, erreurs coûteuses. Gardez des exemples en réserve, jamais utilisés pour régler les prompts, et retirez les données confidentielles inutiles.
- Figer les conditions de comparaison. Versions exactes, contexte, outils, effort de raisonnement, nombre de tours, règles de notation. Comparez à configuration égale, puis chaque modèle dans sa meilleure configuration à budget donné.
- Répéter les essais. Plusieurs tentatives par tâche, avec réponses, appels d’outils, erreurs et durées. Mesurez la dispersion au lieu de garder le meilleur essai.
- Vérifier ce qui est livré. Pour du code : tests, régressions, droits d’accès, conventions, revue du diff. Pour du texte : exactitude et sources. Calibrez tout juge automatique sur des annotations humaines.
- Calculer le coût d’une tâche réussie. Tokens, outils, reprises, attente et correction humaine compris.
- Contrôler l’exploitation. Latence, confidentialité, intégration, solution de repli. Rejouez le jeu réservé à chaque mise à jour du modèle ou du harnais.
Mon article sur le banc de test du code généré par IA détaille l’outillage de ces essais. Si votre application répond à partir de documents internes, évaluez aussi la recherche des sources, comme dans une architecture RAG. Devant un score publié, six questions suffisent souvent :
| Question | Pourquoi elle compte |
|---|---|
| Quelle version du test, quel sous-ensemble ? | Verified, Pro et Pro Verified ne mesurent pas la même chose. |
| Qui a mesuré ? | Un chiffre de laboratoire n’est pas une mesure indépendante. |
| Quel effort, quel budget, combien de tentatives ? | o3 a gagné près de 12 points sur ARC-AGI-1 avec 172 fois plus de calcul. |
| Quels outils, quel harnais ? | Avec des outils, on compare des systèmes complets. |
| Quelle incertitude ? | Un écart d’un ou deux points peut relever du bruit. |
| Quel coût par tâche réussie ? | Pour des scores voisins, il peut varier de 1 à 50. |
11.Conclusion : mesurer une capacité, pas une place
Les benchmarks restent indispensables : ils rendent les progrès mesurables, permettent de reproduire des résultats et donnent un langage commun. Les audits de 2026 en montrent aussi les failles : parfois une réussite révèle une fuite, parfois un échec sanctionne une solution correcte.
Alors, les modèles qui dominent les classements sont-ils les meilleurs face à des problèmes nouveaux, en conditions réelles ? Ce sont d’excellents candidats. Leur supériorité sur vos tâches, avec vos contraintes et votre budget, reste à démontrer. Un benchmark est un instrument de mesure ; il ne devrait pas devenir un argument d’autorité qui dispense de lire son protocole.
Pour une application qui intègre un LLM, la comparaison décisive reste celle de vos propres tâches, avec vos règles métier, votre budget et vos exigences de sécurité. Le protocole compte autant que le nom du modèle.
12.Sources et références
Sélection de références principales, consultées le 23 septembre 2026. Les liens associés aux affirmations dans l’article donnent accès aux sources complémentaires et aux détails des mesures.
12.1.Audits de benchmarks
- OpenAI : audits de SWE-bench Verified et SWE-bench Pro↗ · rapport sur SWE-bench Pro↗.
- Epoch AI : revue de SWE-bench Pro↗ · SWE-Bench Pro Verified↗.
- Anthropic : évaluation awareness sur BrowseComp↗.
- OpenAI : incident d’évaluation avec Hugging Face↗ · rapport de suivi↗.
12.2.Classements et méthodes
- LiveBench↗ · HLE-Diamond et son protocole avec outils↗.
- ARC Prize : résultats d’o3 et limites d’interprétation↗.
- Xiao et Cheng : contamination et stabilité des classements↗.
- Arena : contrôle du style dans les évaluations humaines↗ · HarnessTax : effet du harnais↗.
- METR : horizon des tâches longues↗ · essai sur la productivité des développeurs↗.
- SWE-bench↗ · LiveCodeBench↗ · Are We Done with MMLU?↗.