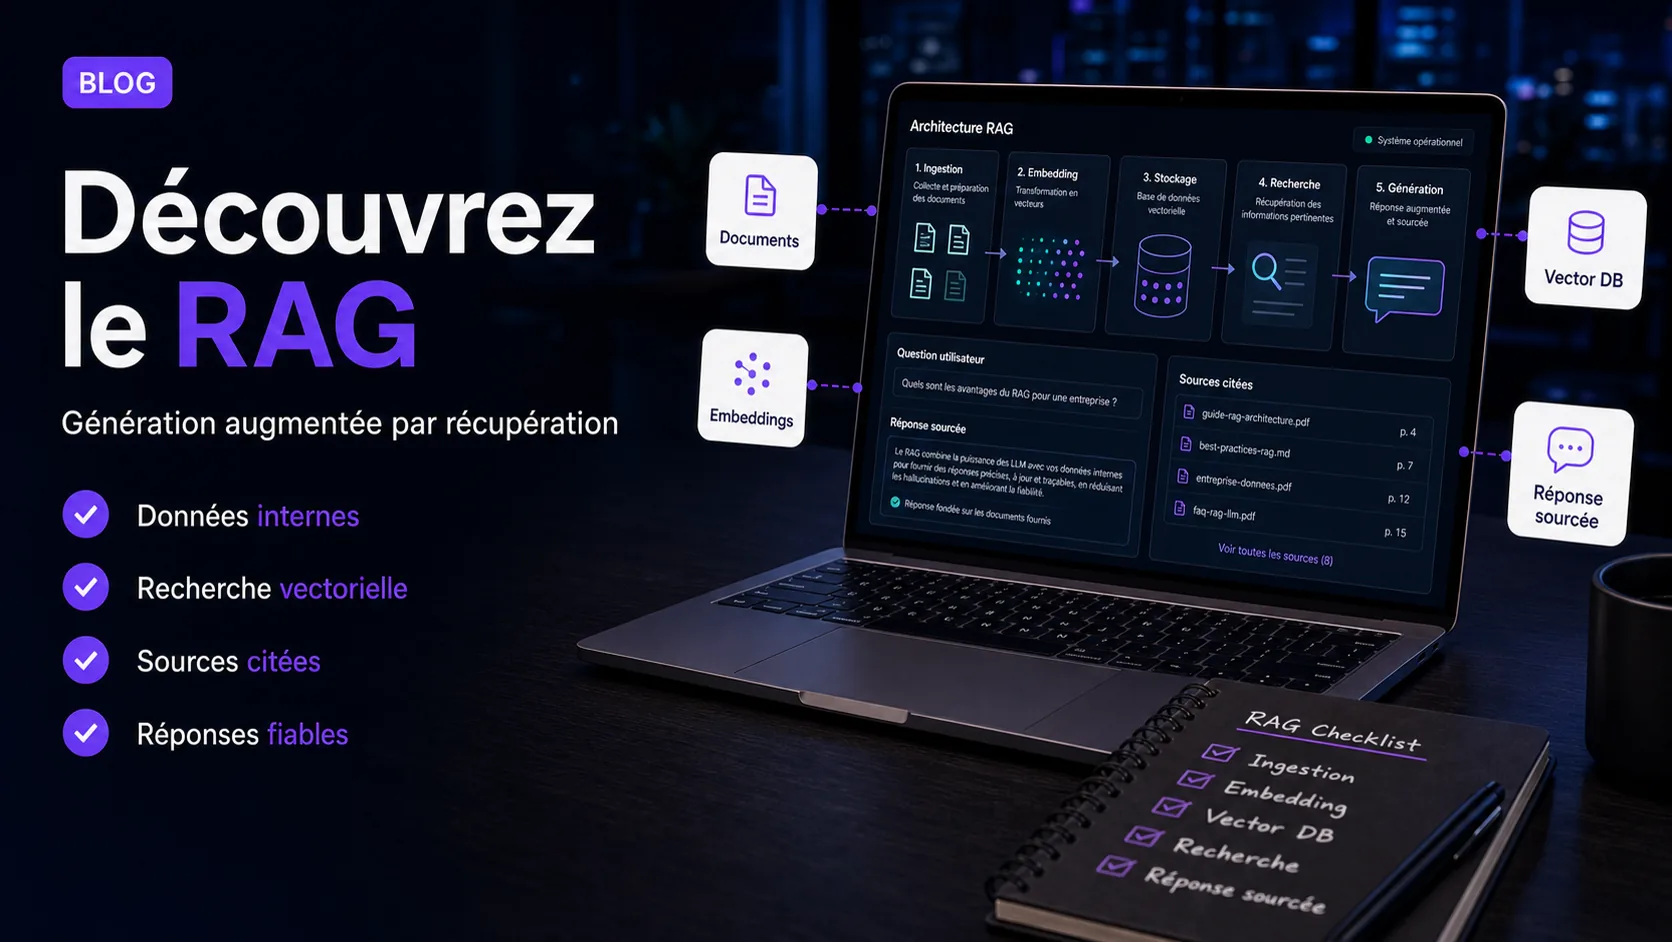
Le RAG (Retrieval-Augmented Generation) fournit au modèle des documents retrouvés au moment de la question. Il peut améliorer la pertinence des réponses, mais son effet dépend de la qualité de la recherche et doit être mesuré sur les questions réelles du projet. L’étude fondatrice de Lewis et al. (2020)↗ compare plusieurs configurations sur des jeux de questions-réponses ; elle n’établit aucun taux universel de réduction des hallucinations.
1.Introduction
Le RAG (Retrieval-Augmented Generation) est l'une des avancées les plus significatives de l'intelligence artificielle appliquée. Cette approche répond au problème majeur des LLMs (Large Language Models) : les hallucinations et les informations obsolètes.
En associant la recherche d'informations précises avec la capacité de génération naturelle, le RAG ouvre la voie à des assistants IA fiables et contextualisés.
2.Qu'est-ce que le RAG ?
2.1.Architecture et fonctionnement
Le RAG fonctionne en deux étapes principales :
1. Phase de récupération (Retrieval)
La première étape consiste à convertir la question de l'utilisateur en vecteur d'embedding, puis à rechercher dans la base de données vectorielle les documents les plus similaires au sens sémantique.
2. Phase de génération (Generation)
La seconde étape ajoute les documents récupérés au contexte du LLM. Le modèle peut alors s’y appuyer et citer ses sources si le système le prévoit, mais il peut aussi les mal interpréter ou répondre malgré une preuve insuffisante.
2.2.Estimer le coût des appels au modèle
Comparez les tarifs de modèles récents à partir du nombre de tokens envoyés et générés. Le résultat estime uniquement le coût du LLM : la recherche, les embeddings et le stockage ont leurs propres coûts.
Tarifs API Standard en USD, sans cache ni traitement par lots, vérifiés le 24 septembre 2026. Voir le tarif officiel de GPT-6 Luna.
Incluez le prompt système et l’historique envoyés à chaque appel.
Comptez uniquement les extraits réellement injectés dans le prompt.
Incluez les tokens de raisonnement facturés, s’il y en a.
Un échange avec plusieurs appels au LLM compte plusieurs fois.
Coût estimé par appel
0,000480 $
Coût estimé par mois
0,48 $
2 300 tokens en entrée × 0,10 $ / million + 500 tokens en sortie × 0,50 $ / million.
Estimation du LLM uniquement : embeddings, indexation, base vectorielle, recherche, outils, taxes et éventuelles majorations régionales ne sont pas inclus. Le coût réel dépend des tokens facturés par l’API et du nombre d’appels. Consultez les tarifs du fournisseur avant de prendre une décision budgétaire.
2.3.Avantages vs LLMs traditionnels
Des réponses ancrées, sous réserve de vérification
Le RAG permet de consulter des documents au moment de répondre, sans réentraîner le modèle à chaque mise à jour. Il ne vérifie pas automatiquement chaque phrase : une recherche incomplète, une source périmée ou une mauvaise interprétation peuvent encore produire une réponse erronée. Pour un usage sensible, il faut tester la qualité des documents retrouvés, la fidélité des réponses à ces documents et la capacité du système à s’abstenir.
Ce que montre la recherche : Dans l’étude de Lewis et al. (2020)↗, RAG-Sequence obtient 44,5 % de réponses exactement correctes sur Natural Questions, contre 41,5 % pour le système DPR comparé dans le même tableau. Ce résultat dépend du jeu de données et de la métrique ; il ne mesure pas un taux général de fiabilité factuelle.
3.Applications concrètes du RAG
3.1.Customer Support intelligent
Chatbots contextualisés
Les chatbots RAG peuvent accéder à une base de connaissances spécifique à l'entreprise, permettant de fournir des réponses précises et à jour sur les produits, services et politiques internes.
Avantages business
Un chatbot RAG peut répondre à certaines questions fréquentes à partir d’une base documentaire et, si les autorisations le permettent, de l’historique du client. Son taux de résolution et son coût doivent être mesurés sur les demandes réelles, avec une possibilité de transfert à un humain. Les réponses ne seront à jour que si les documents, l’index et les droits d’accès le sont aussi.
3.2.Documentation intelligente
Assistant développeur
L'assistant développeur RAG exploite votre documentation et votre codebase pour proposer des réponses contextualisées : il explique le code complexe en langage simple, trouve les APIs pertinentes dans votre documentation, et propose des solutions basées sur des cas similaires déjà résolus dans le projet.
3.3.Recherche d'entreprise
Knowledge Management
Le RAG permet aux employés de rechercher efficacement dans l'ensemble des documents de l'entreprise, avec des filtres de sécurité appropriés et des synthèses intelligentes des informations pertinentes.
Implémentez le RAG dans votre business
Découvrez comment la technologie RAG peut transformer votre service client et vos processus internes.
Explorer les possibilités RAG4.Technologies et outils RAG
4.1.Vector Databases
Solutions populaires
- Pinecone : SaaS vectoriel haute performance
- Weaviate : Open source avec GraphQL
- Chroma : Simple et rapide pour prototypes
- Qdrant : Optimisé pour production
Comparatif bases de données vectorielles
| Base vectorielle | Points forts | Scalabilité | Prix |
|---|---|---|---|
| Pinecone | Managé, simple API | Excellent | Gratuit → 70$/mois |
| Weaviate | Open-source, hybride | Très bon | Gratuit (self-hosted) |
| Qdrant | Open-source, rapide | Très bon | Gratuit (self-hosted) |
| pgvector | PostgreSQL natif | Moyen | Gratuit |
| Chroma | Prototypage facile | Moyen | Gratuit |
| OpenSearch | AWS ecosystem | Excellent | AWS pricing |
4.2.Modèles d'embeddings
Modèles recommandés 2025
Modèles généralistes de pointe :
- text-embedding-3-large : OpenAI, performance de pointe et précision maximale
- BGE M3-Embedding : Support 100+ langues, récupération dense/sparse/multi-vecteur
- Gemini Embedding : Google, 250+ langues, excellente généralisation
- Linq-Embed-Mistral : 1er au benchmark MTEB (score 60.2), basé sur Mistral-7B
Modèles spécialisés :
- Codestral Embed (Mistral) : Spécialisé code, surpasse OpenAI/Cohere en récupération
- QZhou-Embedding : Multi-tâches, données synthétiques, benchmarks MTEB/CMTEB
- EuroBERT : 15 langues européennes, contexte 8192 tokens
- KaLM-Embedding : Multilingue, données diversifiées, benchmark MTEB
Modèles open-source performants :
- Qwen3 Embedding : Tailles variées (0.6B-8B), benchmarks multilingues
- E5-mistral : Équilibré, polyvalent, configurations open-source
- Cohere Embed-3 : Indépendant de la langue, applications multilingues
- DeepSeek Embedding R1 : Rapide, dense, multilingue, économe mémoire
Comparatif modèles d'embedding
| Modèle | Dimensions | Performance | Coût (par token) |
|---|---|---|---|
| text-embedding-3-large (OpenAI) | 3072 | Excellent | $0.00013 |
| text-embedding-3-small (OpenAI) | 1536 | Très bon | $0.000020 |
| embed-v3 (Cohere) | 1024 | Très bon | $0.0001 |
| nomic-embed-text (Ollama) | 768 | Bon | Gratuit (local) |
| all-MiniLM-L6-v2 (HuggingFace) | 384 | Moyen | Gratuit |
4.3.Frameworks de développement
LangChain pour RAG
LangChain simplifie l'implémentation RAG avec des composants pré-construits pour la gestion des embeddings, la recherche vectorielle et l'orchestration des chaînes de traitement.
5.Défis et solutions
5.1.Problèmes techniques courants
1. Qualité des embeddings
- Stratégie de chunking : Découpage optimal des documents
- Modèle d'embedding : Choix selon domaine spécifique
- Précision de récupération : Pertinence des documents récupérés
Le chunking intelligent consiste à découper les documents en segments de taille optimale (généralement 500-1000 tokens) avec un chevauchement de 50-100 tokens pour maintenir la continuité contextuelle.
2. Context window limitations
- Limites de tokens : Gestion des limites contextuelles
- Classement de pertinence : Priorisation des documents
- Conversations multi-tours : Gestion historique chat
3. Performance et coûts
- Optimisation de latence : Temps de réponse acceptable
- Gestion des coûts : Optimisation appels API
- Mise à l'échelle : Montée en charge efficace
5.2.Solutions d'optimisation
Caching intelligent
Le cache sémantique permet de réutiliser les réponses pour des requêtes similaires, réduisant significativement les coûts de calcul et améliorant les temps de réponse.
6.Cas d'usage avancés
6.1.RAG multimodal
Texte + Images + Vidéos
Le RAG multimodal étend les capacités traditionnelles en intégrant des embeddings pour différents types de médias, permettant une recherche unifiée dans du contenu textuel, visuel et vidéo.
6.2.RAG pour code
Assistant programmation
- Recherche de code : Recherche dans bases de code
- Génération de code : Génération basée sur exemples
- Correction de bugs : Solutions basées sur cas similaires
- Documentation : Explications contextualisées
6.3.RAG conversationnel
Mémoire contextuelle
Le RAG conversationnel maintient un historique des échanges pour enrichir les requêtes suivantes avec le contexte des interactions précédentes, créant des conversations plus naturelles et cohérentes.
7.Implémentation pratique
7.1.Architecture de production
Stack technologique recommandé
Une architecture RAG de production inclut typiquement une base de données vectorielle (Qdrant, Pinecone), un cache Redis pour les performances, et des outils de monitoring (Prometheus) pour suivre les métriques de qualité et de performance.
Métriques de monitoring
- Temps de réponse : Latence end-to-end
- Précision de récupération : Précision documents récupérés
- Qualité de génération : Qualité réponses générées
- Suivi des coûts : Coûts par requête
- Satisfaction utilisateur : Feedback utilisateurs
7.2.Bonnes pratiques
Préparation des données
- Nettoyage : Suppression du bruit et formatage
- Chunking optimal : Taille et overlap appropriés
- Métadonnées : Enrichissement informations contextuelles
- Validation : Tests qualité embedding
Optimisation performances 2025
Les optimisations de production incluent le cache des embeddings, la mise en pool des connexions, le rate limiting, et le traitement asynchrone pour gérer efficacement la charge et réduire la latence.
Nouvelles optimisations 2025 :
- HyperRAG : Réutilisation du cache KV du reranker pour améliorer l'efficacité
- TeleRAG : Préchargement anticipé des données pour réduire la latence
- DynamicRAG : Reranking dynamique basé sur la qualité des réponses
- OpenRAG : Optimisation bout-en-bout avec apprentissage contextuel
8.Tendances et futur du RAG
8.1.Évolutions 2024-2025
RAG agents autonomes
- MA-RAG : Framework multi-agent pour tâches complexes avec orchestration collaborative
- Raisonnement multi-étapes : Raisonnement en plusieurs étapes avec agents spécialisés
- Intégration d'outils : Utilisation d'outils externes et APIs
- Auto-évaluation : Auto-évaluation qualité réponses avec feedback loops
RAG multimodal et visuel
- AR-RAG : Récupération autoregressive pour génération d'images avec références visuelles
- ColPali Support : Traitement de documents visuellement riches (Vespa.ai)
- RAG multimodal : Intégration texte, images, vidéos dans un système unifié
- Documents complexes : Compréhension de documents avec éléments visuels
RAG multilingue et multiculturel
- Récupération multilingue : Recherche multilingue avec modèles spécialisés
- Adaptation culturelle : Adaptation contextes culturels et régionaux
- Intégration de traduction : Traduction transparente en temps réel
- Transfert de connaissances : Transfert connaissances entre langues et cultures
8.2.Technologies émergentes
Graph RAG
Le Graph RAG utilise des graphes de connaissances pour enrichir la recherche en exploitant les relations entre entités, permettant une compréhension plus profonde du contexte et des connexions sémantiques.
9.Conclusion
Le RAG relie la génération de texte à une recherche documentaire. Il peut rendre un assistant plus utile sur des informations propres à l’entreprise, à condition de mesurer séparément la qualité de la recherche, celle des réponses et leur coût.
9.1.Avantages et limites à évaluer
- Pertinence : comparer les réponses avec et sans recherche sur les questions représentatives du projet
- Erreurs factuelles : contrôler les affirmations sans preuve et la fidélité aux documents retrouvés
- Actualité : maintenir les sources et l’index à jour sans réentraîner le modèle
- Traçabilité : afficher les documents utilisés et vérifier que les citations soutiennent réellement la réponse
- Coût : inclure le modèle, les embeddings, la recherche, le stockage et la supervision humaine
Pour décider : constituez un échantillon de questions métier, fixez des critères de réussite, puis comparez un système avec et sans recherche documentaire. Le gain éventuel doit justifier la complexité et le coût supplémentaires.
Pour une entreprise, l’intérêt du RAG tient à l’accès contrôlé à ses propres connaissances. Sa fiabilité dépend autant de la qualité des données et des tests que du modèle choisi.
Un système RAG devient réellement utile lorsqu’il est relié aux documents, droits d’accès et outils déjà utilisés par l’entreprise. Ce type d’intégration relève d’un développement web sur mesure, avec une API, une stratégie de recherche et une interface adaptées au cas d’usage plutôt qu’un simple chatbot générique.